Spracherkennung Deutsch: So funktioniert sie wirklich
Spracherkennung Deutsch erklärt: Modelle, Dialekte, Genauigkeit und Datenschutz nach DSGVO. Kompakter Guide für Professionals.
Wenn Du viel schreibst, ist eine Zahl sofort greifbar: Mit Diktat sind rund 150+ Wörter pro Minute möglich und das ist laut fluesta etwa 3x schneller als Tippen. Das klingt erst mal nach Tempo. Im Alltag geht es aber oft um etwas anderes: Du verlierst beim Sprechen weniger Gedanken auf dem Weg zur Tastatur.
Viele Professionals kennen das. Die Idee ist klar, aber beim Tippen wird sie kleinteilig. Noch ein Satz umstellen, noch ein Name korrigieren, noch kurz zurück an den Anfang.
Genau deshalb lohnt sich ein nüchterner Blick auf Spracherkennung Deutsch. Nicht als Technikdemo, sondern als Werkzeug für Mails, Notizen, Konzepte, Arztbriefe, Stellungnahmen oder Protokolle. Und ehrlich gesagt auch mit den Stellen, an denen Deutsch Maschinen bis heute ins Schleudern bringt.
Inhaltsverzeichnis
- Warum 150 Wörter pro Minute den Alltag verändern
- So arbeitet ein ASR System für Deutsch
- Warum Deutsch für Spracherkennung so knifflig ist
- Wie gut deutsche Spracherkennung heute wirklich ist
- Spracherkennung als BFSG Pflicht ab Juni 2025
- DSGVO CLOUD Act und die Wahl des Anbieters
- Tipps für sauberes Diktieren und ein ruhiger Abschluss
Warum 150 Wörter pro Minute den Alltag verändern
Wenn Du diktierst, arbeitest Du oft näher an Deiner natürlichen Denkgeschwindigkeit. 150+ Wörter pro Minute sind für eine Desktop Diktierlösung wie fluesta der Richtwert für produktives Arbeiten, direkt an der Cursor Position und systemweit im Schreibfluss. Die Einordnung dazu findest Du auch auf der Seite zu 150+ Wörtern pro Minute und 3x schneller als Tippen.
Der Unterschied ist im Berufsalltag schnell spürbar. Ein Arztbrief entsteht häufig als klare Abfolge von Beobachtung, Befund, Einschätzung. Das ist ein Format, das sich gut sprechen lässt, weil die Gedanken in Reihenfolge kommen. Ähnlich bei einer Mandanten Mail, einer internen Entscheidungsvorlage oder einer Follow up Nachricht nach einem Meeting.
Es geht nicht nur um Geschwindigkeit
Viele verwechseln Diktieren mit einem Wettkampf gegen die Tastatur. Darum geht's nicht. Der eigentliche Hebel ist kognitive Entlastung.
Wenn Du tippst, zerlegst Du einen Gedanken in viele kleine motorische Schritte. Wenn Du sprichst, formulierst Du direkter. Das hilft besonders dann, wenn Du schon genau weißt, was Du sagen willst, aber keine Lust hast, jeden Halbsatz einzeln einzuhacken.
Praktische Regel: Diktat lohnt sich vor allem bei Texten, die Du auch einer Kollegin frei erklären könntest.
Zwei typische Beispiele aus dem Alltag
Beim Arztbrief oder bei einer fachlichen Zusammenfassung ist die Struktur meist klar. Du gehst Punkt für Punkt durch. Sprechen passt hier gut, weil Du nicht ständig zwischen Denken, Tippen und Korrigieren springst.
Bei einer Mandanten Mail ist es ähnlich. Du kannst den Kern erst einmal flüssig aussprechen, danach kürzt Du nach. Viele gute Texte entstehen sowieso in zwei Schritten. Erst Rohfassung, dann Schärfung.
• Für klare Rohfassungen: Diktier zuerst den Inhalt komplett aus. Kürzen und glätten kommt danach.
• Für wiederkehrende Formate: Mails, Status Updates und Gesprächsnotizen funktionieren oft besonders gut, weil die Struktur vertraut ist.
• Für volle Arbeitstage: Diktat spart nicht nur Minuten. Es spart kleine Kontextwechsel, die beim Schreiben ständig Energie ziehen.
Spracherkennung Deutsch ist deshalb nicht bloß ein Komfort Feature. Sie verändert, wie Du Text produzierst. Damit das zuverlässig klappt, muss man aber verstehen, was im Hintergrund überhaupt passiert.
So arbeitet ein ASR System für Deutsch
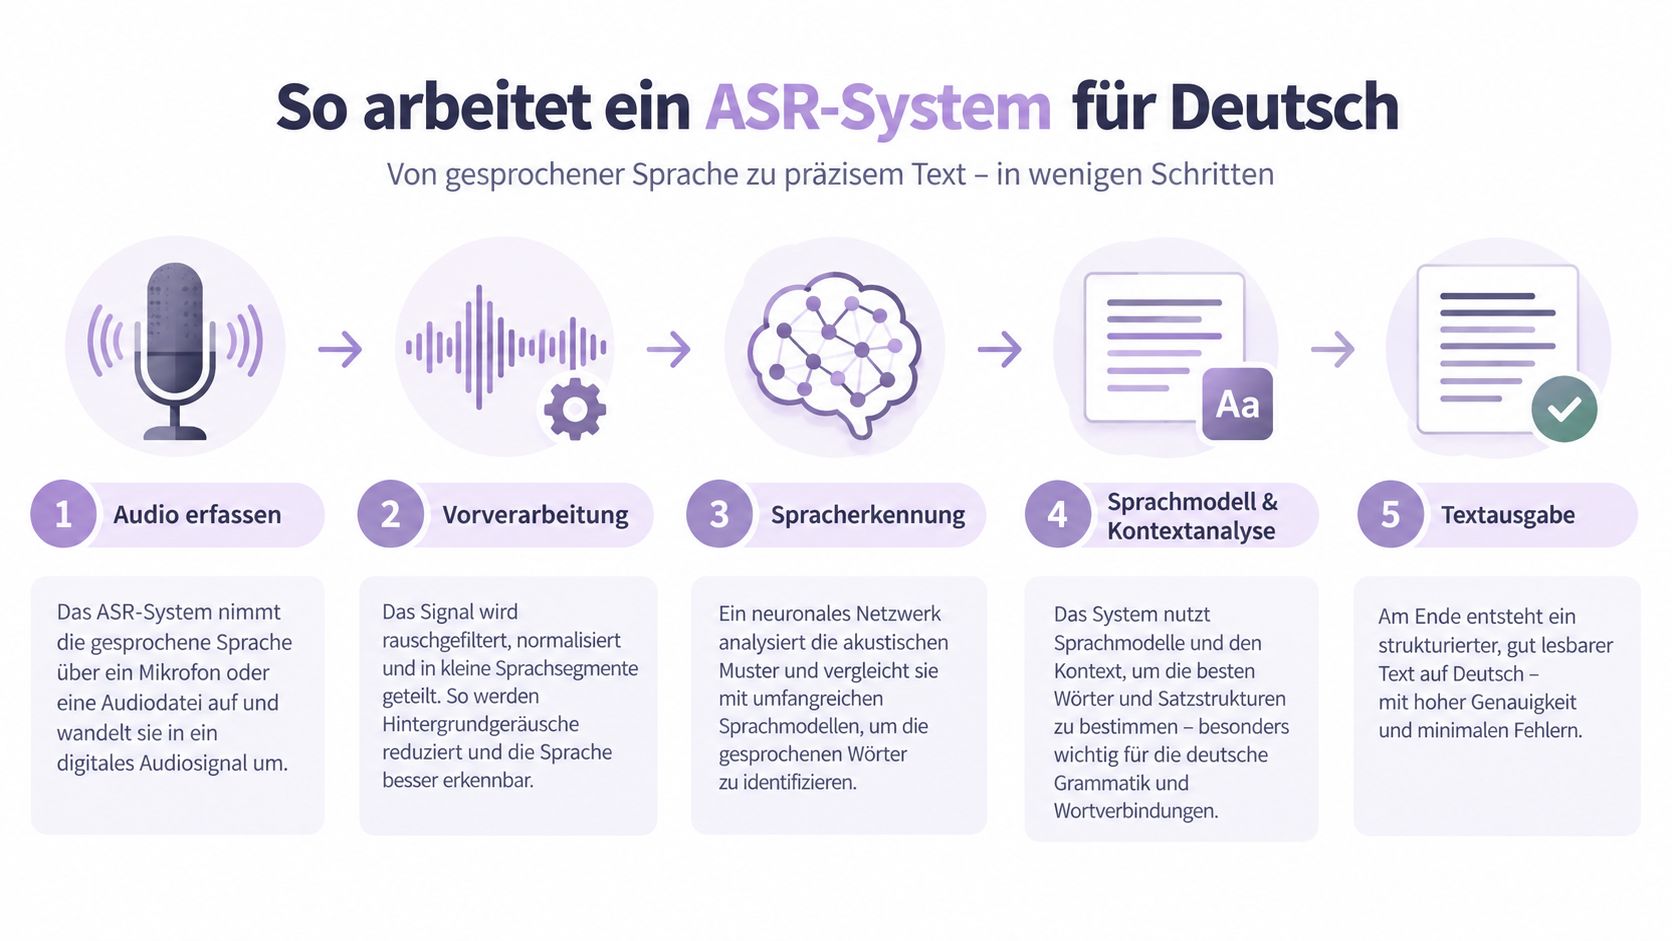
Automatische Spracherkennung, kurz ASR, wirkt von außen simpel. Du sprichst, ein Text erscheint. Innen drin läuft aber eine Kette von Entscheidungen ab, die aus Schall schrittweise Sprache macht.
Zur Orientierung hilft eine einfache Analogie. Das Mikrofon sind die Ohren. Das akustische Modell ist das Innenohr. Der Decoder ist der Dolmetscher. Das Sprachmodell ist der Lektor, der am Ende prüft, welche Wortfolge im Deutschen plausibel klingt.
Vom Audiosignal zum Text
Am Anfang steht roher Ton. Das System bekommt kein Wort, sondern nur eine Wellenform. Deshalb wird das Signal zuerst vorbereitet. Typisch sind Rauschunterdrückung, Lautstärke Normalisierung und die Zerlegung in kleine Zeitfenster.
Danach sucht das Modell nach Mustern, die zu Lauten, Silben oder kleineren Spracheinheiten passen. Früher war das oft eine Pipeline mit vielen getrennten Bauteilen. Heute sind die Systeme viel stärker integriert.
Die Entwicklung von deutscher Spracherkennung zeigt übrigens, wie lange dieser Weg schon läuft. Laut einer Hochschulfolie wurde 1991 das erste System vorgestellt, das bis zu 30.000 deutsche Wörter erkennen konnte. 1993 folgte ein System für den Massenmarkt, das rund 1.000 US Dollar kostete. 1997 erschien das erste System für PC Endnutzer. Die Chronologie ist in der Darstellung zur Entwicklung deutscher Spracherkennung zusammengefasst.
Akustik, Decoder, Sprachmodell
Das akustische Modell bewertet: Welche Laute passen zu diesem Stück Audio am ehesten. Der Decoder baut daraus Kandidaten. Nicht nur ein Wort, sondern mehrere mögliche Folgen.
Dann kommt das Sprachmodell ins Spiel. Es bewertet, welche Reihenfolge im Deutschen am wahrscheinlichsten ist. Das hilft bei Mehrdeutigkeiten. Ein nuscheliges Signal kann akustisch zu mehreren Wörtern passen. Das Sprachmodell entscheidet mit, welche Variante im Satzkontext Sinn ergibt.
Ein gutes deutsches ASR System hört nicht nur hin. Es rät kontrolliert, auf Basis von Sprachmustern.
Warum heutige Modelle anders gebaut sind
Frühere Systeme arbeiteten oft modular. Ein Teil für Akustik. Ein Teil für Aussprache. Ein Teil für Wortfolgen. Das war kontrollierbar, aber aufwendig.
Heute dominieren End to End Modelle wie Whisper oder Conformer. Sie fassen mehr Verarbeitung in einem gemeinsamen System zusammen. Das senkt die Zahl der Einzelteile. Gleichzeitig steigt die Bedeutung großer Trainingsmengen, sauberer deutscher Feinanpassung und verlässlicher Tests.
Für deutschsprachige Trainingsdaten ist die Basis heute deutlich größer als früher. Das Projekt Spoken Wikipedia Corpora weist für Deutsch aktuell 1.010 Artikel, 339 Sprecherinnen und Sprecher und 386 Stunden Audio aus. Davon sind 249 Stunden wort aligned und 129 Stunden phonetisch ausgerichtet, laut der Übersicht zu deutschsprachigen Sprachressourcen. Wenn Du tiefer in praktische Diktier Setups einsteigen willst, ist die fluesta Dokumentation für systemweites Diktieren ein guter technischer Anschluss.
Warum Deutsch für Spracherkennung so knifflig ist
Deutsch ist nicht schwer, weil Maschinen Deutsch hassen. Deutsch ist schwer, weil mehrere Probleme gleichzeitig auftreten. Dialekte, lange Komposita, freie Satzstellung und reale Akustik treffen oft in demselben Arbeitsmoment aufeinander.
Die größte Überraschung für viele: Ein System kann bei sauberem Hochdeutsch ordentlich wirken und im Alltag trotzdem plötzlich stolpern. Nicht weil es kaputt ist, sondern weil Alltagssprache eine andere Belastungsprobe ist als ein kontrollierter Testsatz.
Dialekt ist kein Randfall
In einer deutschen ASR Analyse sank die Erkennungsleistung bei regionalen Akzenten gegenüber Standarddeutsch messbar, weil akustische Modelle stark auf Hochdeutsch trainiert wurden. Das wird in der Fraunhofer Veröffentlichung zu lokalisierten ASR Effekten klar benannt.
Für den Alltag heißt das: Bayerisch, Schwäbisch oder süddeutsche Färbungen sind kein exotischer Sonderfall. Sie sind für viele Nutzer schlicht normale Arbeitssprache. Eine aktuelle Arbeit zu Dialekt ASR verweist zudem auf Evaluationsdaten für drei südostdeutsche Dialektgruppen und Hochdeutsch. Das zeigt, dass zuverlässige Erkennung außerhalb von Standarddeutsch weiter ein aktives Forschungsproblem ist, wie in der Besprechung der Dialekt ASR Arbeit hervorgehoben wird.
Formelles Deutsch ist nicht gleich Alltagsdeutsch
Für deutsche Modelle sind große Fachkorpora wertvoll. Das Dataset ASR Bundestag umfasst 610 Stunden alignierte Audio Transkript Paare plus 1.038 Stunden unlabeled Audio aus Plenar und Ausschusssitzungen des Deutschen Bundestags, laut der Beschreibung des Bundestag Korpus.
Das ist klasse für formale Sprache, Sprecherwechsel und politische Fachbegriffe. Es bildet aber nicht automatisch den Sound eines Großraumbüros in Stuttgart ab.
| Hürde | Beispiel | Betroffene ASR-Komponente |
|---|---|---|
| Dialekt | Bayerisch, Schwäbisch, Norddeutsch | Akustisches Modell |
| Komposita | Vergütungsabschlag, Kraftfahrzeughaftpflichtversicherung | Sprachmodell, Decoder |
| Fachsprache | juristische oder medizinische Begriffe | Sprachmodell |
| Raumakustik | Hall, Laptop Mikro, Bürogeräusche | Vorverarbeitung, Akustik |
| Freie Satzführung | Umstellungen im gesprochenen Satz | Decoder, Sprachmodell |
Wenn jemand mit süddeutschem Einschlag in normalem Tempo durch ein Fachthema spricht, ist das eine härtere Prüfung als jeder Demo Satz.
Komposita machen Druck auf das Sprachmodell
Deutsch baut lange Wörter zusammen. Für Menschen ist das normal. Für Modelle sind solche Wörter oft selten, lang und kontextabhängig.
Deshalb sollte man Marketing Behauptungen über angeblich perfekte Erkennung vorsichtig lesen. Nicht jede gute Demo bedeutet alltagstaugliche deutsche Spracherkennung.
Wie gut deutsche Spracherkennung heute wirklich ist
Wenn man ASR ernsthaft beurteilen will, reichen Bauchgefühle nicht. Die zwei wichtigsten Messlatten heißen WER und CER.
WER, also Word Error Rate, zählt falsche, fehlende oder zusätzlich eingefügte Wörter. CER, also Character Error Rate, schaut auf Zeichenebene. Gerade bei deutschen Komposita kann CER hilfreicher sein, weil ein langes Wort nicht einfach nur richtig oder falsch ist, sondern oft teilweise korrekt erkannt wird.
Was eine Trefferquote im Alltag bedeutet
Eine in Deutschland zitierte Studie berichtet für typische Diktatsituationen mit nur einer sprechenden Person eine Trefferquote von etwa 85 Prozent. Das steht in der Einordnung zur automatischen Spracherkennung in Deutschland.
Das klingt zunächst solide. Praktisch heißt es aber auch: Fehler bleiben sichtbar. Darum nutzen viele Diktier Profis das Rohtranskript als Entwurfsbasis und planen eine kurze Korrekturschleife fest ein.
Nicht jeder Test sagt etwas über Deinen Alltag
Ein Laborwert auf sauberem Hochdeutsch ist nicht dasselbe wie ein echter Tag mit Headset, Slack Pings, Namen aus dem CRM und halb geöffnetem Fenster. Genau deshalb ist der Testkorpus so wichtig.
Wikipedia Sprechdaten helfen für allgemeine Modelle. Für Berufspraxis sind aber juristische, medizinische oder unternehmensinterne Kontexte oft aussagekräftiger. Dort tauchen Eigennamen, Fachbegriffe und lange Sätze auf, die im normalen Web Audio seltener sind.
| Modell | Hochdeutsch (Common Voice) | Süddeutsch / Dialekt | Domäne Medizin |
|---|---|---|---|
| Allgemeines ASR Modell | qualitativ oft stärker | qualitativ anfälliger | qualitativ anfälliger |
| Deutsch feinjustiertes Modell | qualitativ stabiler | abhängig von Dialektabdeckung | qualitativ besser bei Fachsprache |
| Domänenspezifisch angepasstes Modell | qualitativ solide | weiterhin abhängig von Aussprache | qualitativ am nützlichsten |
Wichtiger Unterschied: Gute Spracherkennung spart Schreibarbeit. Sie ersetzt nicht automatisch die letzte fachliche Prüfung.
Warum CER bei Deutsch oft hilfreicher ist
Bei einem Wort wie Kraftfahrzeughaftpflichtversicherung ist ein einzelner Fehler nicht trivial. WER zählt meist das ganze Wort als Fehler. CER zeigt genauer, ob das Modell fast richtig lag oder komplett daneben.
Das ist für Professionals relevant. Denn Korrekturaufwand hängt nicht nur daran, ob ein Wort falsch ist. Er hängt daran, wie falsch es ist.
Spracherkennung als BFSG Pflicht ab Juni 2025
Spracherkennung wird in Deutschland oft als Komfort Funktion besprochen. Das greift zu kurz. Seit dem 28. Juni 2025 verpflichtet das Barrierefreiheitsstärkungsgesetz, kurz BFSG, private Unternehmen in vielen digitalen Kontexten zu barrierefreien Angeboten, wie in der Einordnung zum BFSG ab 2025 beschrieben wird.
Für Produktteams ist das eine echte Perspektivverschiebung. Spracheingabe ist dann nicht nur nett für Vielschreiber. Sie kann eine alternative Eingabemethode sein, die Zugänglichkeit überhaupt erst praktisch macht.
Aus Komfort wird Prozesspflicht
Wenn jemand Formulare, Desktop Workflows oder interne Fachsoftware nicht gut per Tastatur nutzen kann, wird Spracheingabe plötzlich operativ wichtig. Dann reicht es nicht, irgendwo ein Mikro Symbol einzubauen.
Die Frage ist konkreter: Funktioniert die Eingabe in echten Formularfeldern. Lässt sie sich dokumentieren, testen und wiederholen. Kann ein Team nachweisen, dass die Alternative im Arbeitsprozess nutzbar ist.
Warum das gerade für Professionals zählt
Viele denken bei Barrierefreiheit zuerst an Websites. Im Alltag von Unternehmen hängen aber auch interne Tools, CRM Masken, Notizen, Tickets und Freitextfelder daran.
Spracherkennung sitzt hier an einer interessanten Schnittstelle. Sie hilft bei Produktivität und kann zugleich Teil einer sauberen Zugänglichkeitsstrategie sein. Gerade im Desktop Umfeld ist das oft der übersehene Engpass.
• Für Software Teams: Spracheingabe früh mitdenken, nicht nachträglich dranhängen.
• Für Compliance Verantwortliche: Dokumentation und Testbarkeit gehören dazu, nicht nur die Oberfläche.
• Für Führungskräfte: Barrierefreiheit betrifft auch interne Prozesse, nicht nur den öffentlichen Webauftritt.
DSGVO CLOUD Act und die Wahl des Anbieters
Sobald Du Sprache verarbeiten lässt, landet oft sensibles Material im System. Mandantengespräche, Personaldaten, Strategie Memos, Gesprächsnotizen oder medizinische Inhalte. Dann reicht die Frage nach Genauigkeit allein nicht.
Bei professioneller Spracherkennung gehört immer auch die Anbieterfrage dazu. Vor allem in Europa.
Warum US Recht selbst bei EU Servern relevant bleibt
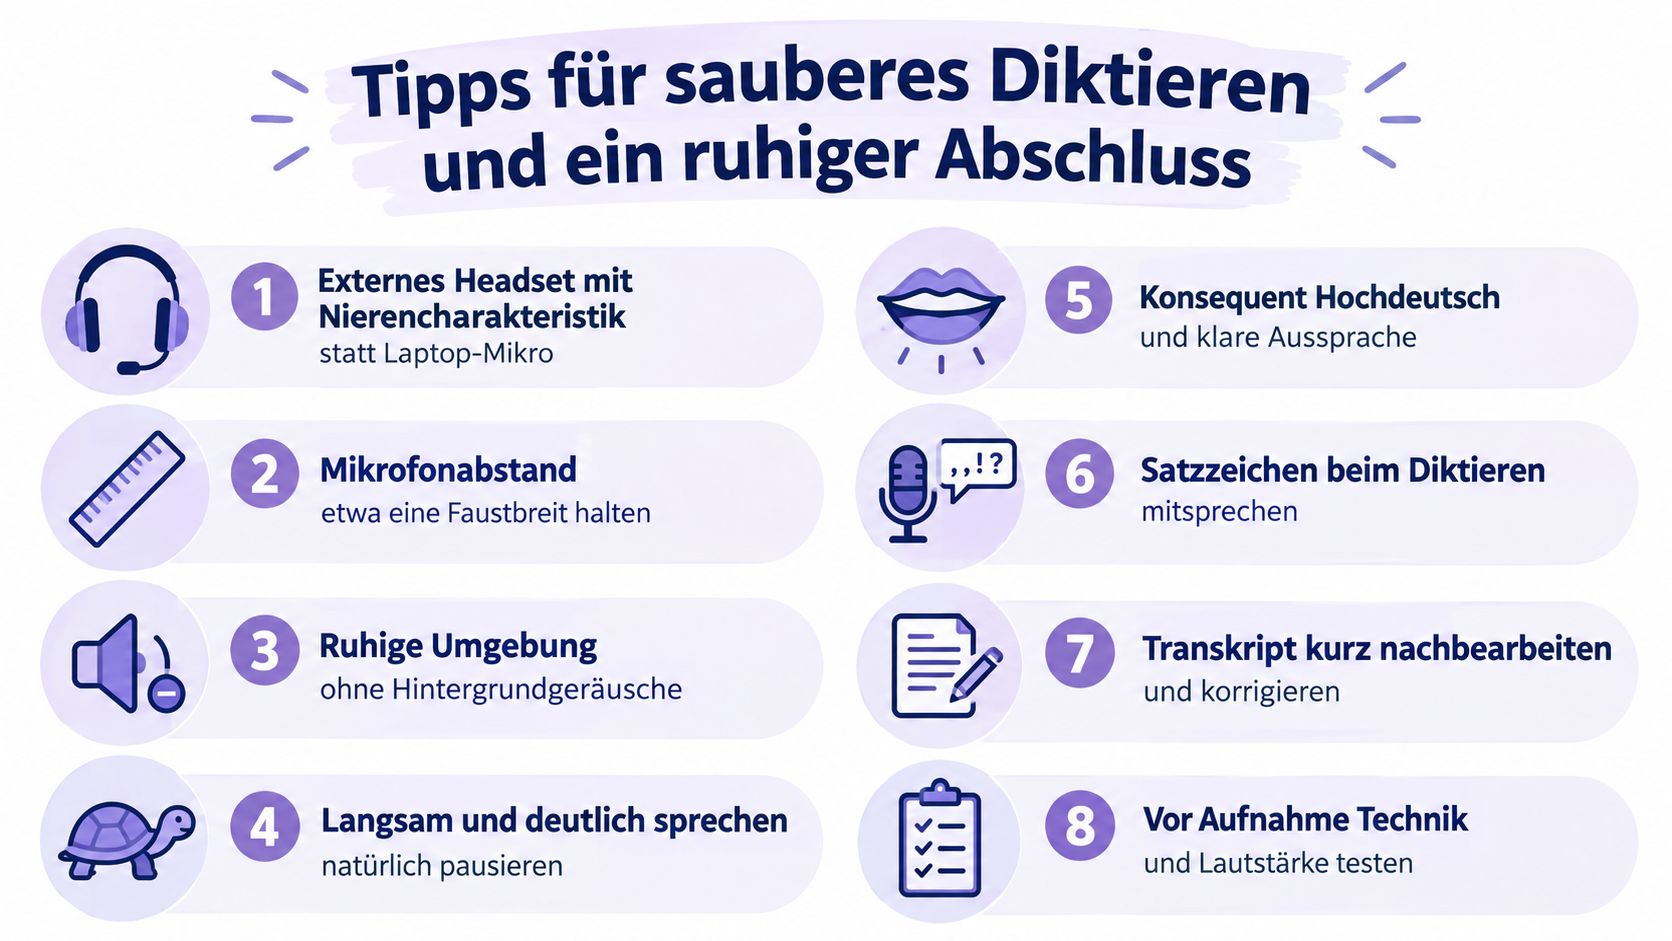
Der zentrale Konfliktpunkt ist Artikel 48 DSGVO. Eine Herausgabe personenbezogener Daten an Drittstaatenbehörden ist danach grundsätzlich nur auf Basis einer internationalen Übereinkunft vorgesehen, etwa eines Rechtshilfeabkommens. Mehrere deutschsprachige Fachquellen betonen zugleich, dass der CLOUD Act auch dann greifen kann, wenn Daten in der EU gespeichert sind, sobald der Anbieter US Recht unterliegt. Die rechtliche Spannung wird in der Analyse zum Konflikt zwischen DSGVO und CLOUD Act gut erklärt.
Das ist der Punkt, an dem viele Marketing Aussagen zu kurz greifen. Serverstandort Frankfurt allein ist keine vollständige Antwort, wenn die juristische Zugriffskette woanders endet.
Woran Du einen Anbieter prüfen kannst
Bei Diktier Workflows mit vertraulichen Inhalten würde ich vier Dinge immer konkret anschauen.
• Datenresidenz: Wo laufen die Inferenz Server wirklich und unter welcher Jurisdiktion steht der Anbieter.
• Datennutzung: Wird Audio nur verarbeitet oder zusätzlich gespeichert, analysiert oder zum Training verwendet.
• Vertragliches Setup: Gibt es eine saubere Auftragsverarbeitung und klare Aussagen zur Löschung.
• Unternehmensstruktur: Ist der Anbieter selbst US gebunden oder unabhängig davon.
Eine Option in diesem Feld ist fluesta. Simon und Furkan haben die App in Berlin aufgebaut. Sie läuft auf Mac und Windows, funktioniert systemweit in jedem Programm, ist EU gehostet, setzt auf Zero Data Retention und positioniert sich als alltagstauglich bei voller Privatsphäre. Die Datenschutzseite mit den konkreten Angaben findest Du unter Datenschutz und Zero Data Retention bei fluesta.
Die eigentliche Entscheidung ist organisatorisch
Es geht nicht nur darum, welches Modell transkribiert. Es geht darum, ob Deine Organisation den gesamten Weg vertreten kann. Also Eingabe, Verarbeitung, Speicherlogik und Löschkonzept.
Wer Spracheingabe beruflich nutzt, sollte den Anbieter so prüfen wie einen Dokumentenspeicher. Audio ist kein harmloser Nebendatensatz.
Tipps für sauberes Diktieren und ein ruhiger Abschluss
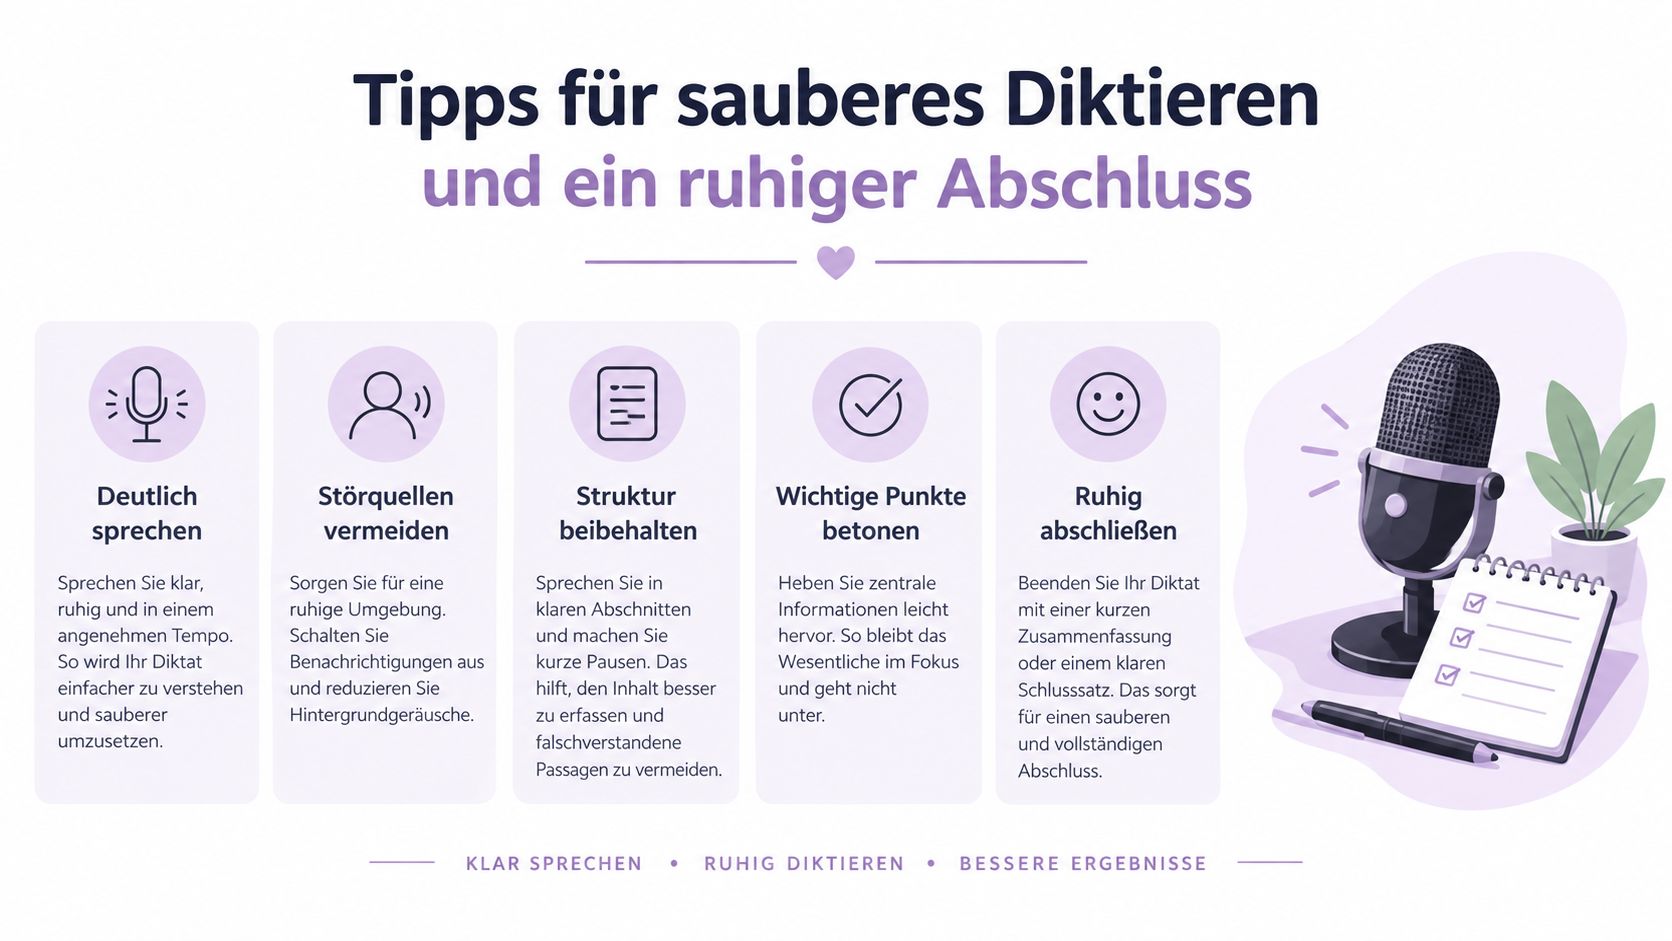
Gute Spracherkennung beginnt selten beim Modell. Sie beginnt bei kleinen Gewohnheiten. Das ist die gute Nachricht, weil Du viele Fehlerquellen selbst entschärfen kannst.
Die folgende Grafik fasst den Alltag gut zusammen.
Setup zuerst, Stil danach
Das Laptop Mikro ist bequem, aber oft nicht die beste Wahl. Ein externes Headset liefert meist ein stabileres Signal, weil Abstand und Richtung konstanter bleiben. Auch der Raum zählt. Hall, Lüfter und Nebengespräche kosten schnell Qualität.
Beim Sprechen hilft nicht künstliche Theateraussprache, sondern Ruhe. Deutlich sprechen, sauber pausieren, Satzzeichen mitsprechen, Namen bewusst betonen. Gerade im Deutschen lohnt es sich außerdem, sehr lange zusammengesetzte Begriffe kurz bewusst zu artikulieren.
Meine alltagstauglichen Regeln
• Externes Mikro wählen: Ein Headset ist oft stabiler als das eingebaute Laptop Mikro.
• Abstand konstant halten: Etwa eine Faustbreit vor dem Mund funktioniert im Alltag meist gut.
• Kurz anwärmen: Sprich vor längeren Diktaten ein oder zwei Probesätze, statt direkt mit dem schwierigsten Absatz zu starten.
• Satzzeichen mitsprechen: Punkt, Komma oder neuer Absatz helfen dem Rohtext sichtbar.
• Komposita bewusst sprechen: Lange Wörter nicht verschlucken, besonders bei Fachsprache.
• Eigennamen vorbereiten: Namen, Produkte oder Fachbegriffe einmal bewusst und konsistent aussprechen.
• Kurze Stille lassen: Vor und nach dem Diktat hilft ein kurzer ruhiger Moment dem System und Dir selbst.
• Nachbearbeitung einplanen: Ein Rohtranskript ist selten die Endfassung. Eine kurze Korrekturschleife gehört dazu.
Worum es am Ende wirklich geht
Spracherkennung Deutsch ist heute nützlich, aber nicht magisch. Sie nimmt Dir viel Schreibaufwand ab, vor allem bei wiederkehrenden Texten und klaren Gedankengängen. Ihre Grenzen liegen oft nicht in der Grundidee, sondern in Dialekt, Fachsprache, Raumakustik und Datenschutz.
Die gute Nachricht ist: Genau diese Grenzen kann man sauber managen. Mit realistischer Erwartung, gutem Setup und einer durchdachten Anbieterwahl wird Diktieren für viele Professionals zu einem normalen Teil des Arbeitstags.
Wenn Du das Thema praktisch ausprobieren willst, schau Dir fluesta an. Simon und Furkan bauen in Berlin eine Speech to Text Desktop App für Mac und Windows, die systemweit in jedem Programm funktioniert, EU gehostet ist und auf Zero Data Retention setzt. Der Pro Plan liegt bei €14 pro Monat, aktuell mit 50 Prozent Betaphase Rabatt.
Related articles
Speech to Text Converter App im Vergleich: Genau, privat
Speech to Text Converter App im Vergleich: Genauigkeit, Datenschutz, Plattform-Support und Preis. Finde die richtige Lösung für deinen Workflow.
Speech Recognition Mac: Diktieren mit Datenschutz
Nutze Speech Recognition Mac für systemweite Texteingabe. Erfahre, wie du 150 Wörter pro Minute schreibst und deine Daten mit EU-Hosting schützt.
Schreiben ohne Tastatur: Wege, Tipps und Datenschutz
Schreiben ohne Tastatur: alle Methoden von Diktat bis OCR, mit Datenschutz-Hinweisen und Empfehlungen für Mac und Windows.