Spracherkennung KI: Funktion, Einsatz und Datenschutz
Spracherkennung KI erklärt: wie sie funktioniert, wo Du sie im Alltag einsetzt und worauf Du beim Datenschutz achten solltest.
43 Prozent der Unternehmen in Deutschland, die 2023 KI nutzten, setzten Technologien zur Spracherkennung ein. Damit war Spracherkennung der häufigste konkrete KI-Anwendungsbereich, noch vor der Automatisierung von Arbeitsabläufen mit 32 Prozent und Text Mining mit 30 Prozent, wie die Bitkom-Auswertung zur KI-Nutzung in deutschen Unternehmen zeigt.
Diese Zahl erzählt eine andere Geschichte als die vom experimentellen Chatbot. Gesprochene Sprache in geschriebenen Text zu verwandeln ist längst Büroalltag, nur leiser und unauffälliger als die großen KI-Debatten. Wer täglich Angebote, Protokolle, E-Mails und CRM-Notizen schreibt, merkt das an einer anderen Stelle: an den Stunden, die fürs Tippen draufgehen.
Spannend wird es im Detail. Wie kommt aus Schall eigentlich Text heraus? Wo spart Sprechen wirklich Zeit, und wo kostet es mehr Korrektur, als es bringt? Und was muss ein Dienst erfüllen, damit Deine Stimme nicht an einer Stelle landet, an der Du sie nicht haben willst?
Inhaltsverzeichnis
- Warum Spracherkennung mit KI im Büroalltag gerade zählt
- Wie KI-Spracherkennung aus Schall Text macht
- Anwendungsfälle, bei denen Sprechen schneller ist als Tippen
- Warum die Trefferquote je nach Situation schwankt
- Datenschutz bei KI-Spracherkennung richtig prüfen
- Den ersten Diktat-Test mit eigenen Texten machen
Warum Spracherkennung mit KI im Büroalltag gerade zählt
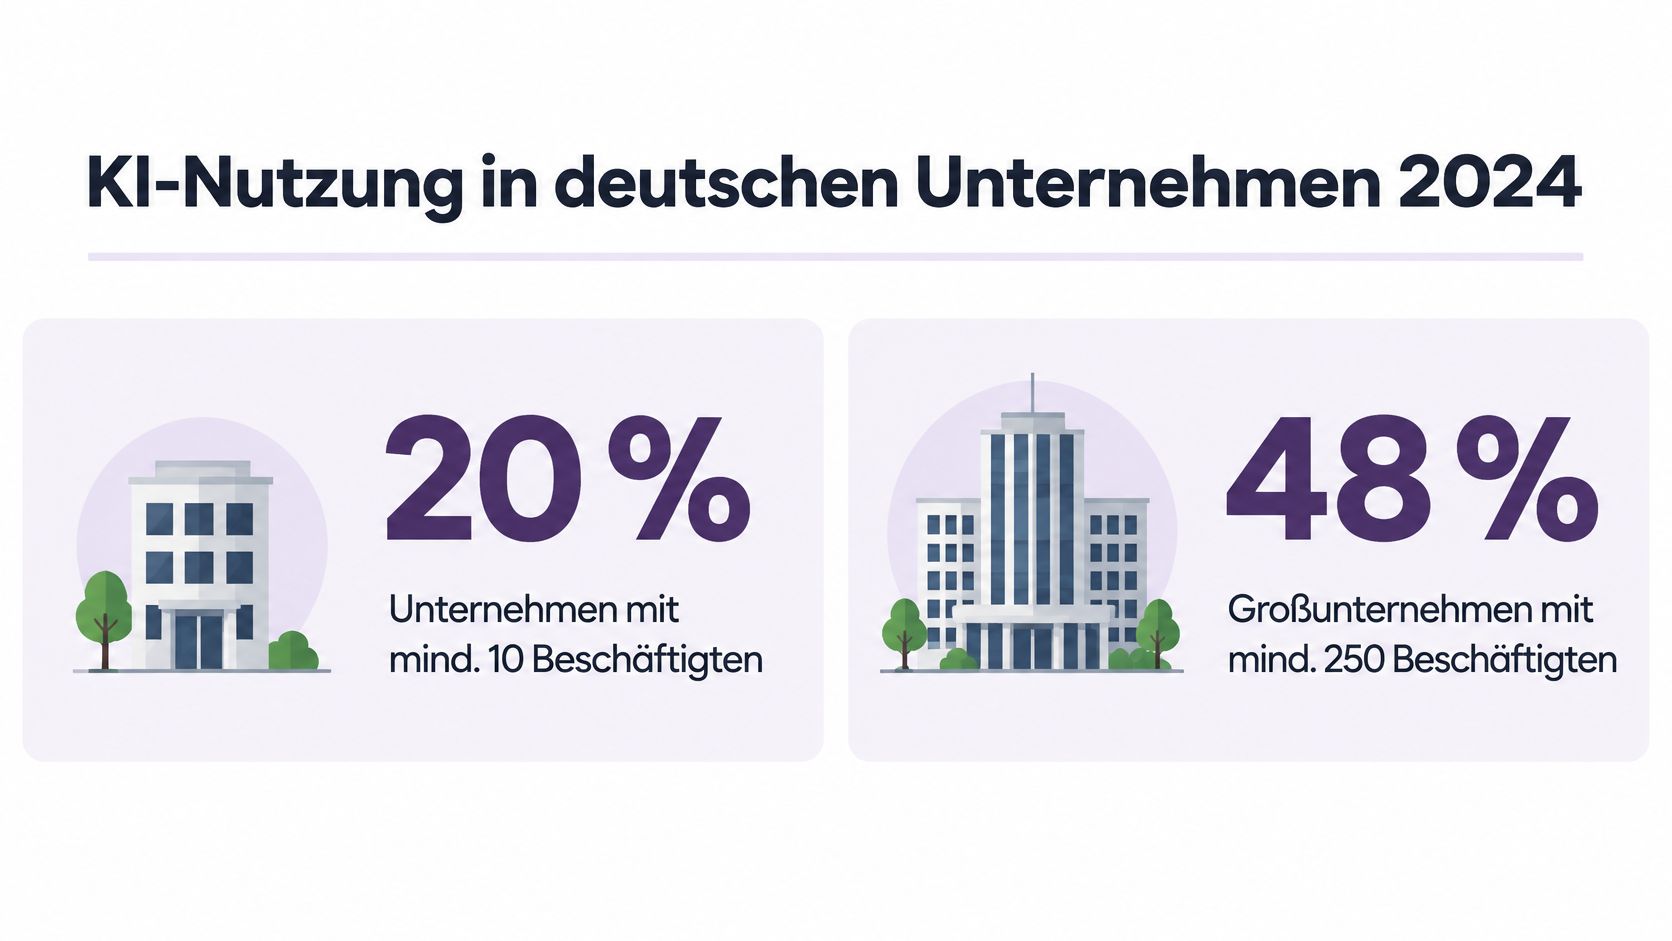
20 Prozent der Unternehmen in Deutschland mit mindestens zehn Beschäftigten nutzten 2024 Technologien der künstlichen Intelligenz. 2023 lag der Anteil bei 12 Prozent, das sind acht Prozentpunkte mehr in einem Jahr. Bei Großunternehmen ab 250 Beschäftigten waren es 48 Prozent, so der Bitkom-Studienbericht zur KI-Nutzung.
Innerhalb dieser Gruppe ist Spracherkennung kein Nischenwerkzeug. 47 Prozent der Unternehmen, die KI einsetzen, nutzen sie für Spracherkennung, fast gleichauf mit der Analyse von Schriftsprache (48 Prozent) und deutlich vor der Erzeugung natürlicher Sprache (34 Prozent). Die Erhebung führt Spracherkennung ausdrücklich als etablierten betrieblichen Einsatzbereich, nicht als Versuch.
Für Dich als Gründer, Freelancer oder Manager sieht der Alltag anders aus als eine Statistik. Es sind die fünfzehn Angebote, die noch raus müssen. Das Protokoll vom Jour fixe. Die Kundennotiz ins CRM, solange das Gespräch noch frisch ist. Und die eigene Konzeptdatei, die seit drei Tagen auf den ersten Absatz wartet.
Genau da liegt der Reiz. Tippen bringt rund 60 Wörter pro Minute auf den Bildschirm, Diktat liegt bei über 150. Der Unterschied ist nicht kosmetisch: Ein Gedanke, der beim Tippen zerfällt, kommt beim Sprechen als ganzer Satz an. Entscheidend ist deshalb nicht das Demo-Video mit Studiobedingungen, sondern der Text, der am Ende im richtigen Programm steht.
Spracheingabe ist damit kein Experimentierfeld mehr. Ob sie in Deinem Fall trägt, entscheidet sich an drei Stellen: wie die Erkennung arbeitet, wo sie Dir Zeit spart und wie Du den Datenschutz prüfst.
Wie KI-Spracherkennung aus Schall Text macht
Eine KI-Spracherkennung ist kein Wörterbuch, das mithört. Sie arbeitet in Stufen, und auf jeder Stufe können Fehler entstehen. Der Ablauf lohnt sich, weil Du danach einschätzen kannst, warum ein Firmenname zuverlässig ankommt und ein anderer nie.
Vom Schall zum Klangmuster
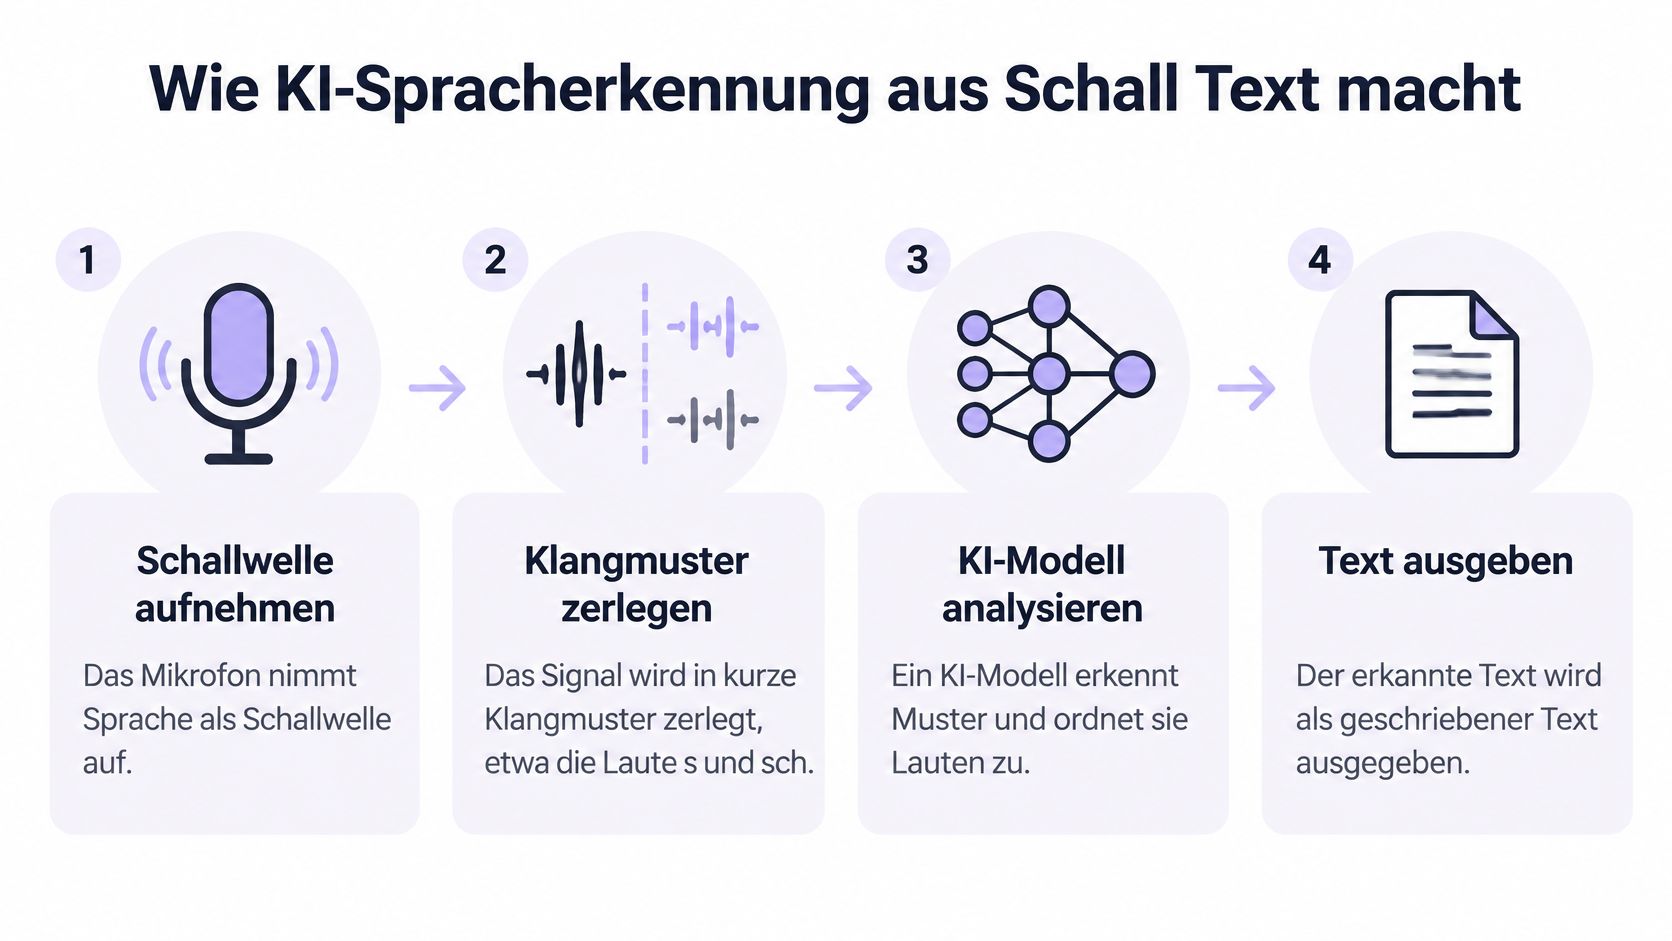
Am Anfang steht eine Schallwelle. Das Mikrofon nimmt sie auf, während Du den Hotkey hältst und sprichst. Aus dieser Welle schneidet die Software kurze Abschnitte heraus und schaut sich an, welche Frequenzen darin stecken. Die Laute s und sch unterscheiden sich genau dort, im Verlauf der hohen Anteile. Das Signal wird also nicht als Buchstabe gelesen, sondern als Muster.
Vom Klangmuster zum Wort
Ein akustisches Modell ordnet diese Muster Lauten zu. Es hat während des Trainings gelernt, dass dieselbe Silbe bei einer norddeutschen und einer bayerischen Sprecherin sehr unterschiedlich klingen kann und trotzdem dasselbe gemeint ist. Deshalb erkennt ein gutes Modell Dialektfärbung bis zu einem gewissen Grad, ohne dass Du Dich verstellen musst.
Neben dem akustischen Modell läuft ein Sprachmodell. Es entscheidet anhand des Satzes, welches Wort an diese Stelle passt. Der Klassiker ist das Paar Mark und Marke. In „Mark trifft die Marke“ legt erst der Zusammenhang fest, wo der Name endet und das Produkt beginnt. Akustisch sind die beiden Varianten ohne Kontext kaum zu trennen.
Die letzte Stufe glättet den Text
Zum Schluss kommt die Nachbearbeitung. Sie ergänzt Satzzeichen, setzt Groß- und Kleinschreibung und hängt den Punkt ans Satzende. Diese Stufe ist der Grund, warum der Text direkt lesbar ist und Du nicht erst Kommas nachtragen musst.
Der Alltagsvergleich: ein Assistent, der zuerst hört, dann Wörter erkennt und den Satz zuletzt glattzieht. Für Dich bleibt sichtbar nur, dass Du sprichst und der Text an der Cursor-Position erscheint. Die Stufen davor laufen im Hintergrund.
| Stufe | Was passiert | Beispiel |
|---|---|---|
| Audio aufnehmen | Das Mikrofon liefert eine Schallwelle | Hotkey halten und sprechen |
| Merkmale erkennen | Das Signal wird in Klangmuster zerlegt | Einzelne Laute wie s und sch |
| Laute zuordnen | Ein akustisches Modell ordnet Muster den Lauten zu | Verschiedene Aussprachen eines Wortes |
| Wörter wählen | Ein Sprachmodell nutzt den Kontext für die richtige Wahl | Mark oder Marke je nach Satz |
| Text glätten | Satzzeichen sowie Groß- und Kleinschreibung werden ergänzt | Ein Punkt am Satzende |
Aus Schall wird Text, weil Merkmale, Laute, Wortwahl und Glättung nacheinander greifen. Wer das einmal verstanden hat, liest Produktversprechen mit anderen Augen.
Anwendungsfälle, bei denen Sprechen schneller ist als Tippen
Die Frage ist nicht, ob Sprechen schneller ist. Die Frage ist, bei welchen Texten es schneller ist. Ein Produktname, den Du dreimal buchstabieren müsstest, ist getippt in zwei Sekunden. Ein Absatz, den Du im Kopf schon fertig hast, ist gesprochen in zwanzig.
Wo Diktat Zeit gewinnt
Es gibt sechs Situationen, in denen sich der Wechsel fast immer lohnt. Entscheidend ist dabei nicht die Wortzahl, sondern wie viel Korrektur danach anfällt. Deshalb steht in der rechten Spalte der eine Punkt, den Du je Fall prüfen musst.
| Anwendung | Typischer Einsatz | Worauf Du achtest |
|---|---|---|
| E-Mails und Chat | Antworten diktieren statt tippen | Anrede, Namen und Anhänge prüfen |
| Konzepte und Entwürfe | Gedanken mündlich festhalten, dann am Bildschirm überarbeiten | Struktur, Quellen und Formulierungen |
| Kurze Notizen | Notizen direkt ins geöffnete Dokument sprechen | Zahlen und Fristen gegenlesen |
| Dokumentation im CRM | Kundennotizen direkt im Eingabefeld erfassen | Fachbegriffe und Produktnamen |
| Protokolle | Ergebnisse nach einem Termin einsprechen | Namen und Entscheidungen korrigieren |
| Meeting-Mitschnitt | Ein Gespräch aufnehmen und transkribieren | Vorab klären, ob alle Beteiligten einverstanden sind |
Der praktische Vorteil einer Desktop-App liegt in der Einfügestelle. Der Text landet direkt in dem Programm, in dem Du gerade arbeitest, ohne Copy-Paste über einen Browser. fluesta funktioniert systemweit in jedem Programm, und genau das ist für viele Teams der entscheidende Punkt. Wer wissen will, woher der Tempo-Unterschied kommt, findet die Zahlen zur Geschwindigkeit von Spracheingabe neben dem direkten Vergleich zum Tippen.
Diktat und Meeting-Mitschnitt sind zwei verschiedene Dinge
Beim Diktat sprichst Du selbst, und Du entscheidest, was gesagt wird. Bei einem Mitschnitt nimmt ein System ein Gespräch zwischen mehreren Personen auf. Das ist rechtlich und praktisch etwas anderes, weil hier Persönlichkeitsrechte anderer berührt sind und die Nachbearbeitung meist aufwendiger wird. Für den Arbeitsalltag heißt das: Beginne mit Diktat, nicht mit Aufzeichnung.
Der Ergonomie-Effekt ist real, aber begrenzt
Eine DGUV-Untersuchung zur mobilen Bildschirmarbeit, die Veränderungen zwischen Pandemiebeginn und einer Befragung von September 2023 bis April 2024 erfasste, berichtet von 42,4 Prozent mit Beschwerden im unteren Rücken, 40,4 Prozent mit Nackenbeschwerden und 28,6 Prozent mit Schulterbeschwerden. Fehlten externe Bildschirme, Tastatur oder Maus, stieg das Risiko für Nacken- und obere Rückenschmerzen zusätzlich, wie die Auswertung der DGUV zur mobilen Bildschirmarbeit festhält.
Spracheingabe kann Tastaturphasen auflockern und den Händen eine andere Tätigkeit geben. Sie ersetzt keine gute Arbeitsplatzgestaltung und keine Pausen.
Ehrlich gesagt: Diktat ist kein Ergonomie-Update für einen schlechten Schreibtisch. Es ist eine zweite Eingabemethode für lange Textstrecken.
Nach dem Diktat kommt die Prüfung. Lies den Text einmal gegen, bevor er rausgeht. Namen, Zahlen und Zusagen kontrollierst Du, alles andere darf stehen.
Warum die Trefferquote je nach Situation schwankt
Eine Angabe wie „95 Prozent Genauigkeit“ ist ohne Beschreibung des Tests wenig aussagekräftig. Die Word Error Rate (WER) setzt falsch erkannte Wörter ins Verhältnis zur Gesamtzahl der Wörter im Referenztext. Sie hilft beim Vergleichen, sagt aber nur dann etwas über den eigenen Alltag aus, wenn Testtexte und Sprechbedingungen dazu passen.
Was die Word Error Rate wirklich misst
In einer technischen Fehleranalyse deutscher Spracherkennung lagen moderne Architekturen auf dem relativ kontrollierten Mozilla-Common-Voice-Datensatz bei etwa 6,28 bis 13,90 Prozent. Auf Bundestagsreden erreichten sie rund 13,25 bis 13,65 Prozent, auf anspruchsvolleren deutschen TED- und ALC-Daten 25,90 bis 47,75 Prozent. Die Fehleranalyse deutscher ASR-Modelle zeigt damit, wie stark die WER je nach Material schwankt.
Der Grund ist anschaulich: Ein Modell kann Wörter leichter erkennen, wenn Aussprache und Satzkontext vorhersehbar sind. Längere Äußerungen, Fachvokabular, Sprecherwechsel und Akzentvariation machen die Zuordnung schwieriger. Ein Nachrichtentext ist deshalb kein guter Ersatz für ein Fachgespräch.
| Testsituation | Word Error Rate | Einordnung |
|---|---|---|
| Mozilla Common Voice | 6,28 bis 13,90 % | Relativ kontrollierter Datensatz |
| Bundestagsreden | 13,25 bis 13,65 % | Längere, zusammenhängende Reden |
| Deutsche TED- und ALC-Daten | 25,90 bis 47,75 % | Fachvokabular und Sprecherwechsel |
| Standarddeutsch, Voxtral Mini | 3,8 % | Benchmark mit Standarddeutsch |
| Dialekte aus DE, AT, CH, Voxtral Mini | 6,4 % | Regionale Aussprache |
| Standarddeutsch, Deepgram Nova-3 | 5,2 % | Benchmark mit Standarddeutsch |
| Dialekte aus DE, AT, CH, Deepgram Nova-3 | 8,3 % | Regionale Aussprache |
Warum Dialekte die Quote nach oben treiben
Ein deutschsprachiger Modellvergleich nennt für Voxtral Mini eine WER von 3,8 Prozent auf Standarddeutsch und 6,4 Prozent auf Dialektdaten aus Deutschland, Österreich und der Schweiz. Bei Deepgram Nova-3 steigt sie von 5,2 auf 8,3 Prozent. Die Werte stehen im Vergleich deutschsprachiger Spracherkennungsmodelle.
Regionale Aussprache, verkürzte Laute und andere Betonungen erschweren die akustische Erkennung, auch wenn ein Sprachmodell Standarddeutsch gut verarbeitet. Für einen Teamtest heißt das: Bezieht Sprecherinnen und Sprecher aus verschiedenen Regionen sowie typische Bürobedingungen ein.
Warum kleine Tests trügerisch sind
Bei kleinen Tests mit nur einigen hundert Referenzwörtern kann ein einzelner Fehler die WER um mehrere Zehntelprozentpunkte verschieben. Das ist, als würde ein einzelner Ausrutscher in einer kurzen Stichprobe übermäßig stark ins Gewicht fallen. Für einen aussagekräftigen Vergleich braucht es längere, repräsentative Texte aus den eigenen beruflichen Themen und Sprechsituationen.
Auch die Modellarchitektur allein erklärt die Erkennungsqualität nicht. In der Fehleranalyse schnitten Transducer-Modelle insgesamt am besten ab, während Conformer-CTC, ContextNet und Citrinet teilweise weniger als 0,5 Prozentpunkte auseinanderlagen. Ein guter Wert auf einem Datensatz garantiert also keine gleichbleibende Qualität in anderen deutschen Einsatzfeldern.
Für den Test zu Hause: Halte die Bedingungen getrennt. Sprich einmal in einem ruhigen Raum mit gutem Mikrofon, einmal mit Hintergrundgeräusch und jeweils mit Fachvokabular und Deinem eigenen Sprechstil. So erkennst Du, ob eine hohe Trefferquote auch für Deine Texte gilt.
Achte besonders auf Interpunktion und Eigennamen. Ein vertauschtes Funktionswort lässt sich oft schnell korrigieren. Bei einem falschen Namen oder Satzzeichen musst Du den Zusammenhang prüfen und den Satz womöglich neu formulieren. Entscheidend ist deshalb nicht nur die WER, sondern auch, welche Fehler bei Deinen eigenen Texten tatsächlich zusätzlichen Korrekturaufwand verursachen.
Datenschutz bei KI-Spracherkennung richtig prüfen
Stimmaufnahmen sind personenbezogene Daten. Sobald Du geschäftliche Inhalte diktierst, sind in der Regel auch Kunden- oder Kollegendaten dabei. Die Prüfung gehört deshalb vor den ersten Arbeitstext, nicht danach.
Sechs Fragen, die Du jedem Anbieter stellen kannst
Die folgenden Punkte sind als Fragen formuliert, damit Du sie unverändert in eine E-Mail an den Support kopieren kannst. Die Tabelle fasst zusammen, worauf die Antwort zielen soll.
| Prüfpunkt | Worauf Du achten solltest | Warum es zählt |
|---|---|---|
| Serverstandort | Verarbeitung auf EU-Servern | Daten bleiben im europäischen Rechtsraum |
| Speicherung der Sprache | Zero Data Retention, kein Audio wird gespeichert | Sprache liegt nicht dauerhaft auf fremden Servern |
| Rechtsrahmen | Kein US Cloud Act | Geringeres Risiko eines Behördenzugriffs aus den USA, kein absoluter Ausschluss |
| Löschung der Stimme | Löschung auf Wunsch möglich | Du behältst die Kontrolle über Deine Daten |
| Vertrag für Teams | Auftragsverarbeitungsvertrag nach Art. 28 DSGVO | Pflicht, wenn ein Dienstleister die Daten verarbeitet |
| Weitergabe an Dritte | Klare Angaben zu Unterauftragnehmern | Du weißt, wer Deine Daten sonst noch sieht |
Los geht es mit dem Standort. Frage konkret, auf welchen Servern transkribiert und korrigiert wird, und ob das auch für die KI-Korrektur gilt, nicht nur für die reine Umwandlung. Ein EU-Hosting für die Transkription und ein US-Modell für die Nachbearbeitung wäre eine Lücke, die niemand in der Datenschutzerklärung findet.
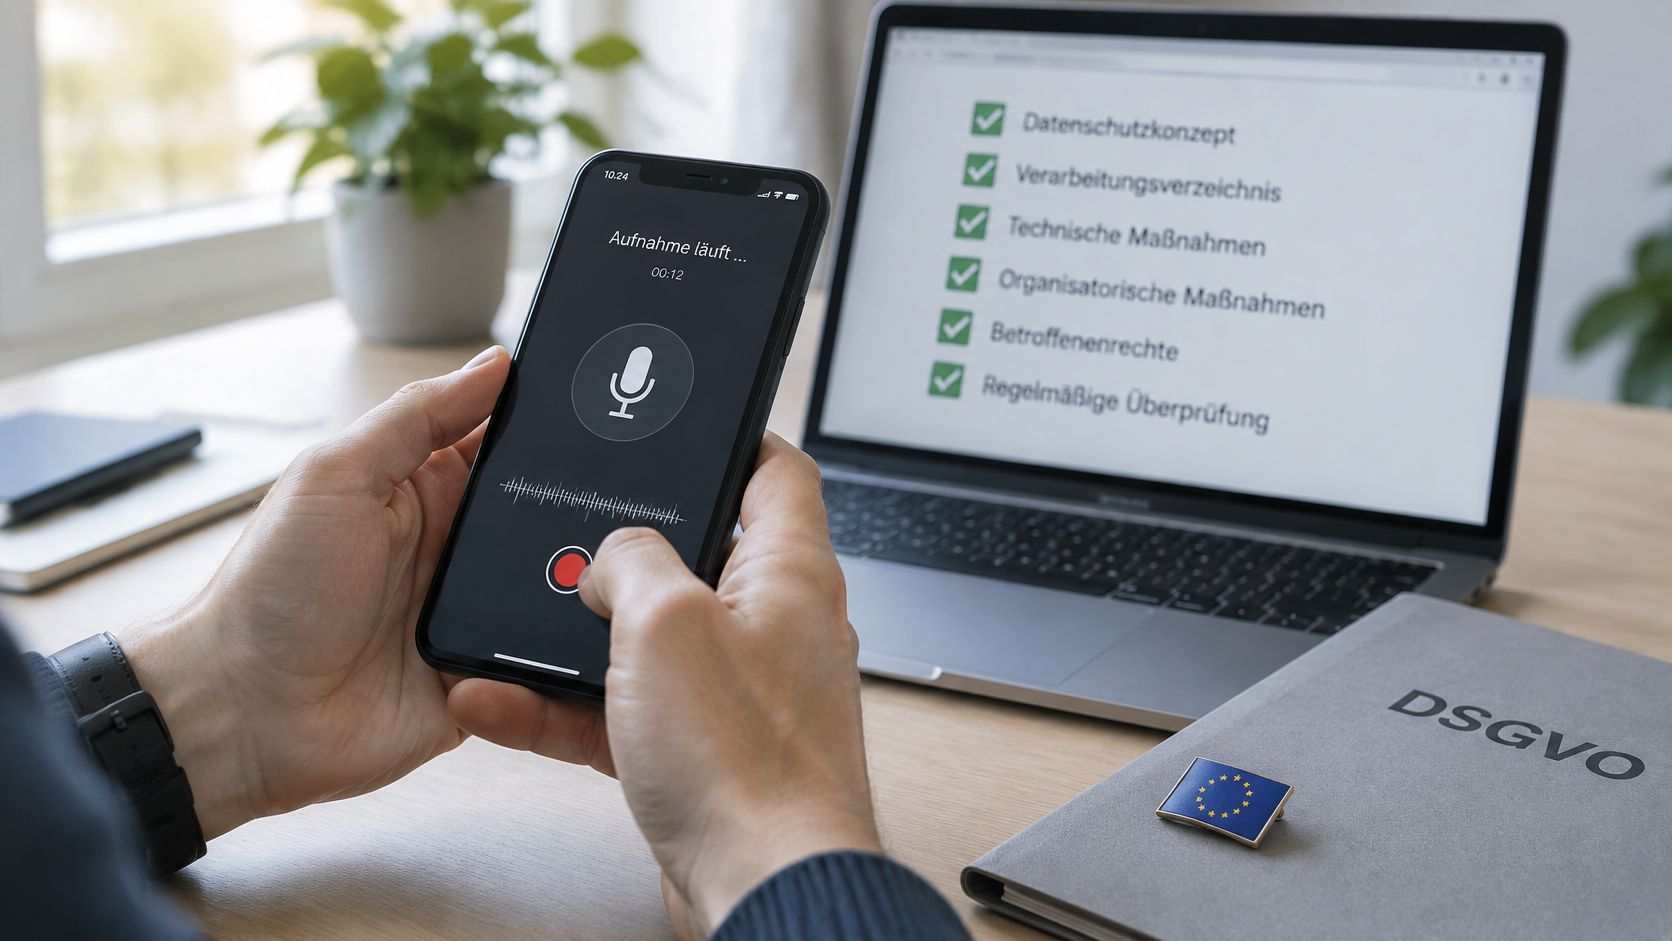
Als Nächstes die Speicherung. Die brauchbare Antwort lautet Zero Data Retention: Das Audio wird für die Verarbeitung genutzt und danach nicht aufbewahrt. Frage zusätzlich nach Logs und nach Trainingsdaten. Ein Anbieter, der Deine Aufnahmen zum Verbessern der Modelle verwendet, sollte das klar sagen.
Dann der Rechtsrahmen. Ein Anbieter, der nicht unter den US Cloud Act fällt, senkt das Risiko eines Zugriffs aus den USA. Das ist eine Risikominderung, kein absoluter Ausschluss. Formuliere die Frage genau so, dann erkennst Du an der Antwort, ob Dein Gegenüber das Thema verstanden hat.
Bei der Löschung willst Du wissen, wie Du sie auslöst und was sie umfasst. Reicht ein Klick im Konto, oder braucht es eine Mail? Werden auch Zwischenstände und Korrekturhistorie entfernt?
Warnsignal: Wenn eine Antwort ausweicht, allgemein bleibt oder auf die Datenschutzerklärung verweist, ohne die Frage zu beantworten, ist das die Antwort.
Was in den Vertrag gehört
Für Teams kommt der Auftragsverarbeitungsvertrag nach Art. 28 DSGVO dazu. Er regelt, was der Dienstleister mit den Daten tun darf und was nicht. Bei fluesta gibt es einen AVV für Teams auf Anfrage, und die Verarbeitung läuft ausschließlich auf EU-Servern nach dem Prinzip Zero Data Retention. Wie das konkret geregelt ist, steht in der Datenschutzerklärung von fluesta. Audio wird nicht gespeichert, und die Stimme ist löschbar, wenn Du das möchtest.
Der letzte Punkt ist die Weitergabe. Frage nach Unterauftragnehmern, also nach den Firmen, die der Anbieter selbst einsetzt. Nur so weißt Du, wer Deine Stimme außer ihm noch sieht. Wer diese sechs Antworten schriftlich hat, kann Diktat im Team freigeben, ohne ein mulmiges Gefühl mitzunehmen.
Den ersten Diktat-Test mit eigenen Texten machen
Deine Stimme, Dein Mikrofon und Deine Fachwörter entscheiden, wie gut die Erkennung sitzt. Der Test, der das zeigt, benutzt Sätze, die Du wirklich schreibst, nicht einen fremden Beispieltext aus dem Netz. Er funktioniert wie eine Probefahrt auf derselben Strecke: gleiche Texte, gleiches Setup, mehrmals hintereinander. Die Dokumentation führt durch Installation, Hotkey-Einrichtung und das erste Diktat, dazu Anleitungen, Referenz und FAQ: Erste Schritte mit Installation, Hotkey und erstem Diktat.
- Einrichten und Hotkey setzen. Taste halten, sprechen, Text erscheint. Prüfe, ob der Satz im Feld landet, in dem der Cursor steht.
- Drei kurze Texte diktieren. Eine echte E-Mail an einen Kunden, eine Notiz mit Zahlen und Fristen, ein Absatz mit Fachbegriffen und Eigennamen. Diese drei Sorten decken den Schreiballtag ab.
- Fehler zählen und einordnen. Notiere pro Text, wie viele Wörter danebenlagen und ob Satzzeichen, Namen oder Fachwörter betroffen waren. Die Kategorie sagt mehr als die Summe, weil die Korrektur Fachbegriffe anders behandelt als eine verhörte Zahl.
- Korrekturzeit messen. Stoppe, wie lange das Aufräumen dauert. Diese Zeit, nicht die reine Trefferquote, zeigt, ob Diktat schneller ist als Tippen.
- Datenschutz gegenprüfen. Geh die sechs Fragen aus dem vorherigen Abschnitt durch, bevor Kundendaten ins Mikrofon gehen. EU-Server und Zero Data Retention gehören zur Einrichtung, nicht zum Nachtrag. Audio wird nicht gespeichert, und die Stimme ist löschbar, wenn Du das möchtest.
Fünf Durchgänge reichen für ein eigenes Bild. Häufig fällt auf, dass lange Entwürfe und Notizen flüssiger laufen als kurze Befehle und Nummern. Bei einem einzelnen Wort oder einer Frist fehlt der Satzkontext, an dem sich eine Korrektur festhalten kann. Solche Stellen bleiben oft Tipparbeit, auch wenn der Rest sitzt.
fluesta ist eine Desktop-App für Mac und Windows. Der Hotkey setzt den erkannten Text in jedem Programm an die Cursor-Position, mit 150+ Wörtern pro Minute, Tippen schafft 60. Der Pro-Tarif kostet 14 Euro im Monat. Auf fluesta.eu stellst Du die Zugangsanfrage. fluesta meldet sich bei Dir, danach läuft dieser Test mit Deiner Stimme und Deinen Texten.
Related articles
10 Sprachnotizen App im Vergleich: Datenschutz und Preise
10 Sprachnotizen App im Vergleich: Funktionen, Plattformen, Datenschutz und Preise. Ehrlich eingeordnet, mit Stärken und Grenzen für den Alltag.
Spracheingabe Software: 10 aktuelle Tools im Vergleich
Spracheingabe Software im Vergleich: 10 Tools für Mac und Windows mit Fokus auf Genauigkeit, Datenschutz, Preis und Tempo 2026.
Best Speech to Text AI: 10 Tools für Teams
Best Speech to Text AI im Vergleich: 10 Lösungen für Genauigkeit, Datenschutz, EU-Hosting, Integration, Latenz, Fachbegriffe und Preise.